„Warum nehmt ihr nicht einfach die größte KI?“ Diese Frage kommt in fast jedem ersten Gespräch, und sie ist berechtigt. Gemeint sind die großen Allgemeinmodelle aus der Cloud: Sie sind beeindruckend, sie sind sofort verfügbar, und die erste Rechnung ist klein.
Frontier-Modelle heißen die jeweils größten Sprachmodelle im Fachjargon, weil sie den aktuellen Stand des Machbaren markieren. Ein Sprachmodell ist das Werkzeug, das aus einer Frage einen formulierten Text macht. Zugespitzt gesagt: Modelle, die alles ein bisschen können und nichts aus Ihrem Haus.
Genau daran hängt die Antwort auf die Frage. Und das „einfach“ darin ist der Teil, der nicht stimmt.
Weltwissen und Unternehmenswissen
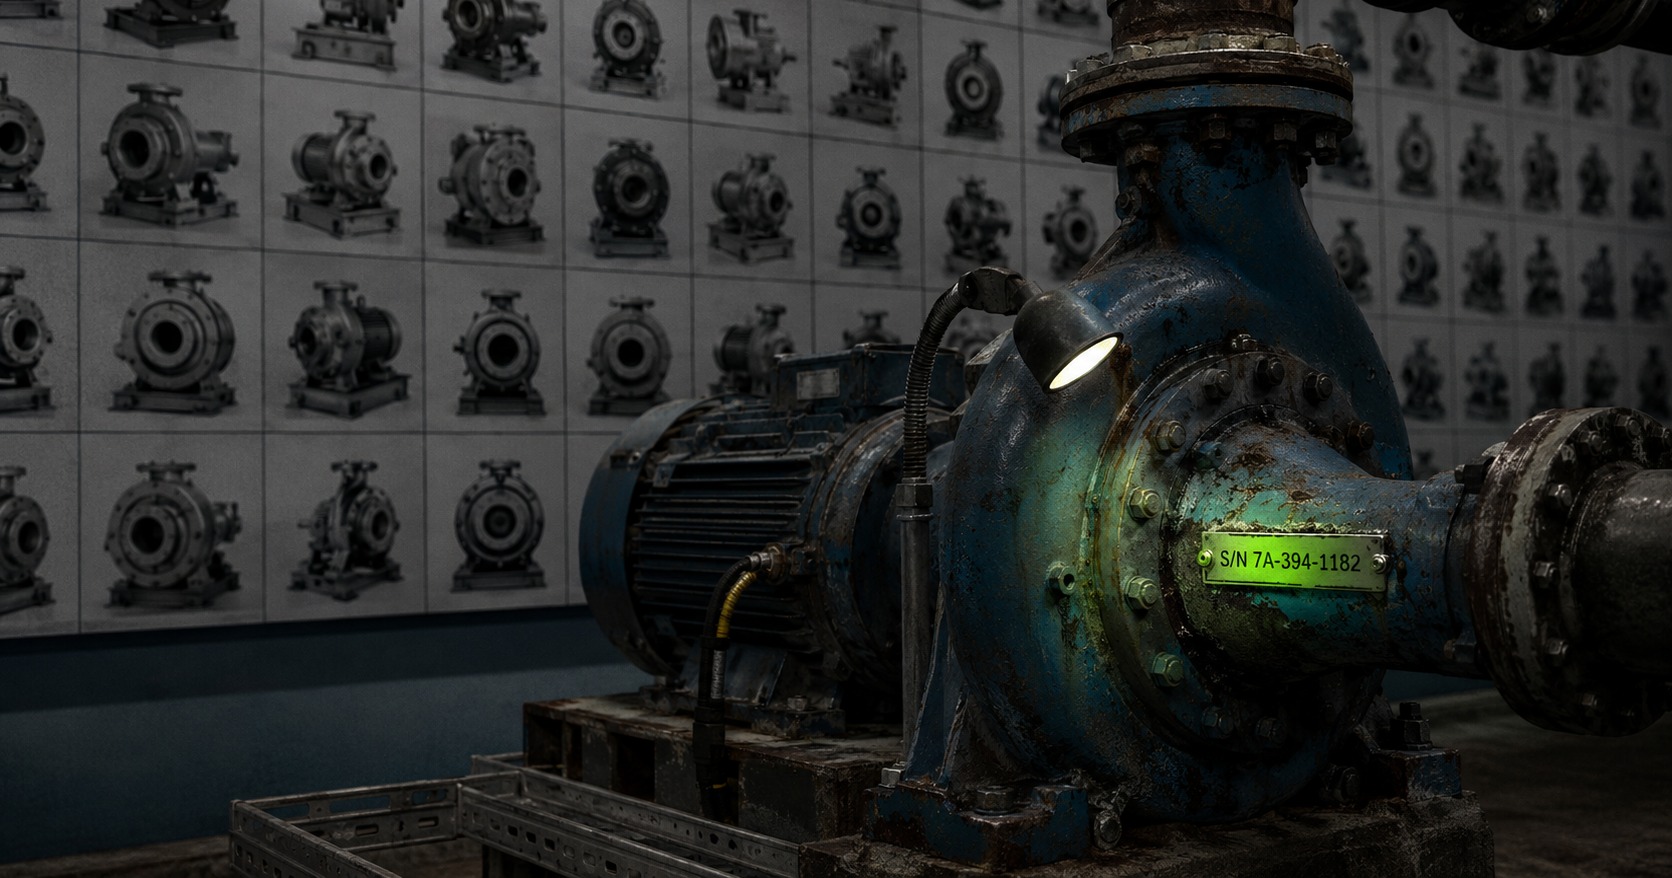
Ein großes Allgemeinmodell hat Weltwissen. Es weiß, wie eine Kreiselpumpe arbeitet, welche Normen es für Druckbehälter gibt und was Kavitation anrichtet. Das ist eine Menge, und es ist beeindruckend.
Was es nicht weiß: welche Pumpe an Linie 3 im Werk Nord steht, wann sie zuletzt gewartet wurde, was der Hersteller in seiner Freigabe von 2019 dazu geschrieben hat und welche Ausnahme der Werkstattleiter drei Jahre später in einer e-Mail festgehalten hat.
Das ist Unternehmenswissen. Es steht in einem Handbuch auf einem Dateiserver. In einer Zeichnung, die seit 2014 niemand mehr geöffnet hat. In einem Prüfprotokoll, das jemand eingescannt hat. Und ein guter Teil davon steht nirgends, sondern wird beim Schichtwechsel weitergesagt.
Kein Sprachmodell hat davon je etwas gesehen. Ein Frontier-Modell ist auf dem groß geworden, was allgemein zugänglich war: Normen, Lehrbücher, Foren, Hersteller-Seiten. Die Freigabe von 2019 war nicht darunter. Die e-Mail des Werkstattleiters auch nicht. Und was beim Schichtwechsel weitergesagt wird, steht in keinem Datensatz der Welt.
Das Problem ist also kein Mangel an Rechenleistung, sondern einer an Zugang. Keine Modellgröße ändert daran etwas.
Über die Güte der Antwort entscheidet nicht die Größe des Modells. Sie entscheidet sich am Zugriff auf das Unternehmenswissen.
Und das soll auch so bleiben. Es gibt genau einen Weg, auf dem ein fremdes Modell erfahren könnte, welche Pumpe an Linie 3 steht: Jemand müsste es ihm sagen. Dieser Jemand wären Sie. Oder jemand aus Ihrem Unternehmen, der es eilig hatte.
Wozu es dann überhaupt ein Sprachmodell braucht
Es bekommt die gefundenen Absätze vorgelegt und formuliert daraus eine Antwort, mit einer Fundstelle je Aussage. Eine eng umrissene Aufgabe.
Finden und Formulieren sind zweierlei. Das Finden ist der schwere Teil: Wer darf welches Dokument sehen, welcher Begriff meint in diesem Unternehmen was, wie kommt man an einen Scan von 1998 heran, wie an ein englisches Handbuch, wenn auf Deutsch gefragt wird. Das Formulieren ist der leichtere Teil, und er ist es, den das Modell übernimmt.
Wer den schweren Teil nicht gelöst hat, bekommt vom größeren Modell eine besser formulierte falsche Antwort.
Was tatsächlich dimensioniert
Wer eine solche Installation auslegt, rechnet meist mit der Zahl der Anwender. Das ist die falsche Größe. Es kommt darauf an, wie viele Fragen gleichzeitig gestellt werden, und das ist eine ganz andere Zahl. Wie hoch sie liegt, weiß man erst, wenn man sie gemessen hat. Die Frage vor der Auslegung lautet deshalb nicht, wie viele Leute im Haus sind, sondern wann viele davon zugleich fragen.
Daneben steht eine zweite Größe, und die beiden werden gern verwechselt. Eine Frage zu beantworten ist laufender Betrieb: Das passiert jedes Mal, wenn jemand etwas wissen will, und es geht schnell. Die Dokumente einzulesen passiert einmal, beim Aufbau der Wissensbasis, und danach nur noch für das, was neu dazukommt.
Wie lange dieses eine Mal dauert, hängt fast nur an der Art der Quellen. Ein Textdokument ist in Sekundenbruchteilen gelesen. Ein eingescanntes Blatt mit Handschrift braucht ein Vielfaches davon, und zwar nicht, weil es langsamer geht, sondern weil mehr geschieht. Das Blatt wird in Zeilen zerlegt. Jede Zeile wird einzeln gelesen, von einem Modell, das Bilder versteht. Jede Zeile bekommt einen Wert dafür, wie sicher die Erkennung ist. Und jede Zeile, deren Wert zu niedrig ausfällt, wird ausgeschnitten und einem Menschen vorgelegt, der entscheidet, was dort steht.
Wer Dateiablagen und Datenbanken anbindet, merkt vom Einlesen wenig. Wer einen gewachsenen Papierbestand anbindet, plant dafür ein eigenes Vorhaben.
Ein größeres Sprachmodell ändert an beidem nichts. Es formuliert vielleicht schöner. Schneller wird die Antwort davon nicht, und mehr über Ihre Anlagen weiß es auch nicht.
Auch schlechte Antworten repariert es nicht. Wenn die Antworten unbrauchbar sind, liegt die Ursache fast immer vor dem Modell: in dem, was ihm überhaupt vorgelegt wird, und in welcher Form. Wer dann das Modell tauscht, tauscht ausgerechnet den Teil, der nicht das Problem war.
Der zweite Teil der Frage
Bleibt der Dienst aus der Cloud, und das ist die bequemere Hälfte der Frage. SaaS nennt sich das, Software as a Service: Die Anwendung läuft beim Anbieter, viele Kunden teilen sich dieselbe Installation, und man mietet einen Zugang, statt etwas zu betreiben. Kein Blech im Serverraum, kein Betrieb, sofort verfügbar. Die Bedenken sind dabei meist mit einem Häkchen erledigt: Ihre Daten werden nicht für das Training verwendet.
Dieses Häkchen ist nicht nichts. Es ist eine Zusage darüber, was der Anbieter mit Ihren Dokumenten tut. Ihre Dokumente sind trotzdem aus dem Haus gegangen.
Eine Zusage lässt sich ändern, mit neuen Bedingungen, einem neuen Tarif oder einem neuen Eigentümer. Und sie lässt sich von außen nicht nachprüfen. Dass etwas nie gegangen ist, kann man belegen. Dass etwas gelöscht wurde, nicht.
Darauf kommt es hier an: Der Dienst ist austauschbar, der Bestand ist es nicht. Ein Sprachmodell tauscht man aus, in NXTGN AI CORE ist das eine Konfigurationszeile, weil Sprachmodell, Embedding und Bildverstehen hinter Schnittstellen liegen und nicht im Kern verdrahtet sind. Beim Embedding kommt die Neu-Indexierung dazu, beim Sprachmodell nicht. Ein Bestand dagegen wächst über Jahre, und die Entscheidung, ihn nach draußen zu geben, trifft man einmal.
Deshalb ist NXTGN AI CORE so gebaut, dass beim Kunden nichts das Haus verlässt. Ein Bild, das beschrieben werden soll, wandert in der Anfrage selbst mit, nie als Link auf einen fremden Rechner. Die internen Dienste lauschen ausschließlich lokal. Das sind keine großen Architekturgesten, das sind Kleinigkeiten in der Umsetzung, und genau an solchen Kleinigkeiten entscheidet es sich.
Wo ein Frontier-Modell sich lohnt
Ich möchte nicht missverstanden werden. Es gibt Aufgaben, für die das größte verfügbare Modell die bessere Wahl ist.
Überall dort, wo aus dem Modell selbst heraus geantwortet werden soll, ohne vorgelegte Quelle. Bei langen Gedankenketten. Bei seltenen Sprachen. Wer einen Entwurf schreiben lassen will, ist mit dem größten Modell gut bedient. Wer wissen will, was im eigenen Handbuch steht, nicht.
Solche Fälle gibt es, und sie sind abzählbar. Sie ändern nichts an der Regel, sie markieren nur ihren Rand.
Mein Resümee
Vieles am schnellen Weg ist richtig gedacht. Der große Dienst ist sofort da, niemand muss etwas betreiben, die erste Rechnung ist überschaubar, und in der Demo sieht das Ergebnis gut aus.
Aber die Frage, die morgens um sieben an der Linie gestellt wird, beantwortet er nicht. Sie lautet nicht „was weißt du über Kreiselpumpen“, sondern „was steht bei uns dazu, und darf ich das sehen“. Dafür braucht es kein größeres Modell, sondern das eigene Unternehmenswissen, die Rechte darauf und eine Fundstelle unter jeder Aussage.
Quellen anbinden, Rechte klären, Scans nachprüfen. Das ist die unbequemere Arbeit, und sie sieht in keiner Demo gut aus.
Über das größte und beste KI-Modell von heute redet in ein paar Jahren niemand mehr. Über die Datenquellen, die jetzt jemand anbindet, noch lange.