„Das Handbuch ist auf Englisch.“ Diesen Satz hört man in der Instandhaltung ständig, und er beschreibt einen Zustand, den niemand geplant hat. Die Anlage kommt aus Italien oder Japan, die Dokumentation des Herstellers ist englisch, und die Leute, die morgens damit arbeiten, fragen auf Deutsch.
Die „naheliegende“ Lösung heißt Übersetzung. Wir bei NXTGN haben sie verworfen.
Zwei Wege mit demselben Fehler
Zwei Varianten standen zur Wahl. Entweder übersetzt man die Frage und sucht zweimal, einmal auf Deutsch und einmal auf Englisch. Oder man übersetzt die Dokumente schon beim Einlesen und legt beide Fassungen ab.
Der erste Weg kostet bei jeder Suche einen zusätzlichen Aufruf des Sprachmodells. Der zweite kostet doppelten Speicher und eine deutlich längere Anbindung.
Das sind aber nur die Preise, und über Preise kann man reden. Der schwerere Einwand ist ein anderer: In beiden Fällen wird die Übersetzung Teil des Bestands.
Ein falsch übersetzter Fachbegriff steht dann in der Antwort auf die nächste Frage. Im Wissensartikel, den jemand daraus schreibt. In der Arbeitsanweisung, die daraus wird. Und irgendwann im Kopf eines Monteurs, der ihn für den richtigen Begriff hält.
Niemand sieht ihm an, dass er einmal etwas anderes war.
Der dritte Weg
In einer KI-Lösung arbeitet nicht ein Programm, sondern mehrere mit getrennten Aufgaben. Das bekannteste ist das Sprachmodell. Es formuliert am Ende die Antwort, und es ist das, was die meisten meinen, wenn sie „die KI“ sagen.
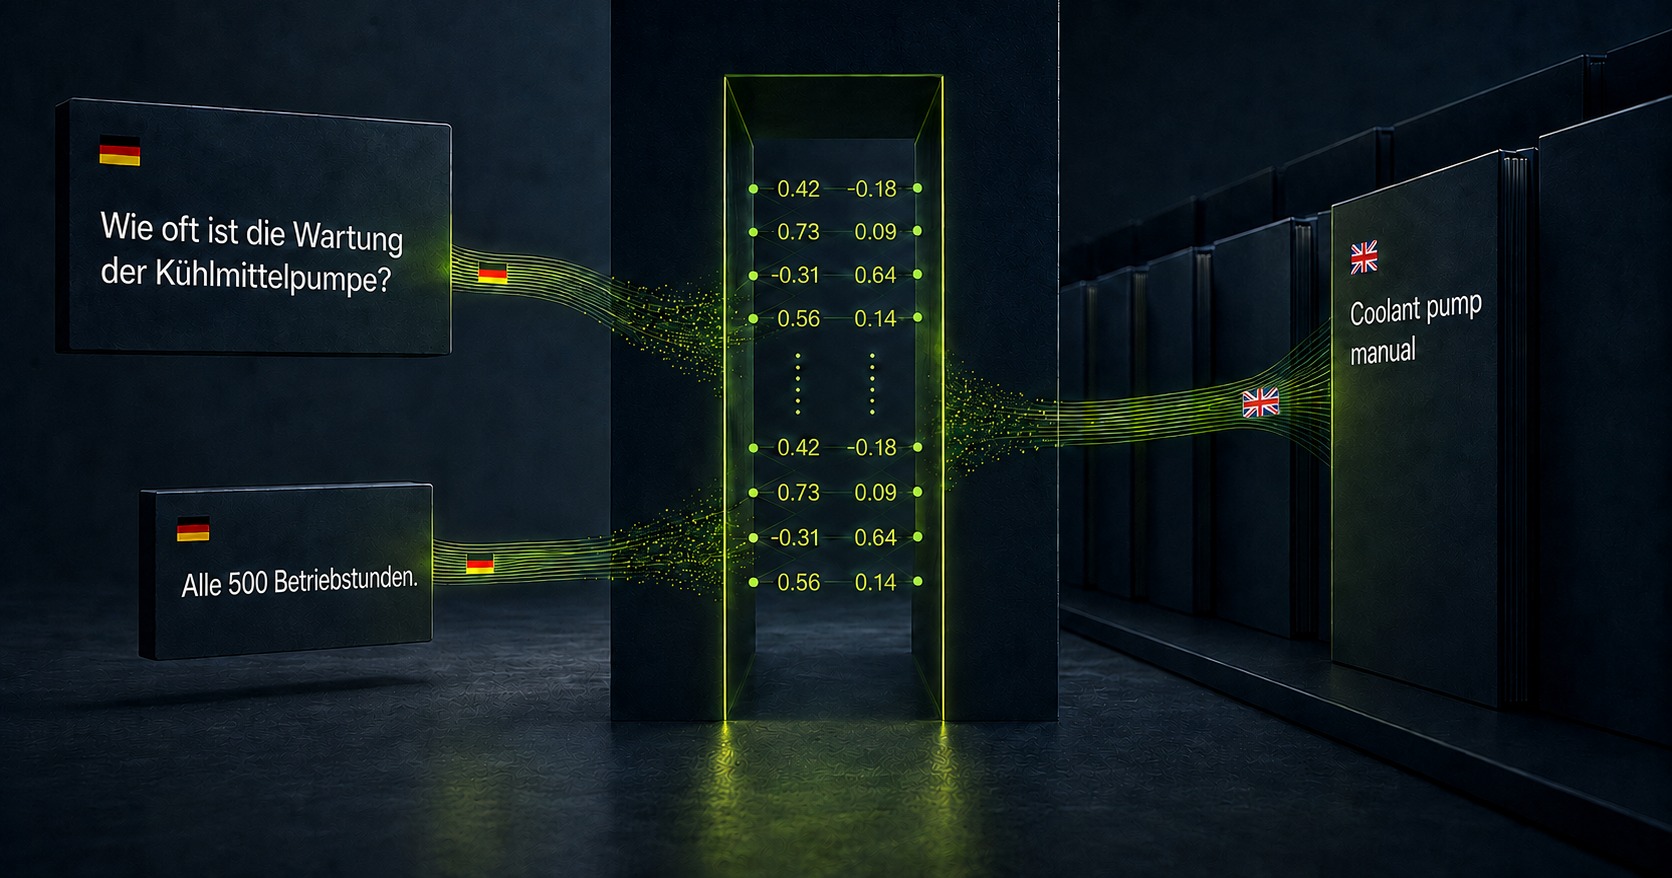
Davor sitzt ein zweites, das niemand zu Gesicht bekommt. Seine einzige Aufgabe ist zu entscheiden, welche Stellen im Bestand überhaupt zur Frage passen. Es vergleicht dafür Bedeutungen: Jeder Satz wird in eine lange Zahlenreihe verwandelt, und ähnliche Bedeutungen landen dicht beieinander. Im Klartext: Es sortiert Sätze nach Sinn statt nach Wörtern. Fachlich heißt es Embedding-Modell.
Ausgetauscht haben wir das zweite. Das Sprachmodell blieb, wie es war.
Ein mehrsprachiges Embedding-Modell legt deutsche und englische Sätze in denselben Raum. Eine deutsche Frage findet dann einen englischen Absatz, weil beide dasselbe bedeuten, und nicht, weil jemand sie ineinander übersetzt hat. Kein zusätzlicher Aufruf, keine zusätzliche Wartezeit, und vor allem keine Übersetzung, die falsch sein könnte. Der Preis ist eine einmalige Neu-Indexierung des Bestands.
Was die Messung zeigte
Wir haben die Ähnlichkeit zwischen der deutschen Frage „Wie oft muss die Kühlmittelpumpe gewartet werden?“ und zwei englischen Sätzen aus demselben Handbuch gemessen, einem passenden und einem unpassenden.
| Embedding-Modell | passender Satz | unpassender Satz | Abstand |
|---|---|---|---|
| bisher | 0,404 | 0,377 | 0,027 |
| neu | 0,564 | 0,427 | 0,137 |
Auf die absoluten Werte kommt es nicht an. Es kommt auf den Abstand an, denn der entscheidet, ob ein System passende von unpassenden Treffern unterscheiden kann. Das bisherige Embedding-Modell konnte das über die Sprachgrenze hinweg praktisch nicht, 0,027 verschwinden im Rauschen. Der Abstand des neuen Embedding-Modells ist das 5,07-fache.
Im Betrieb sieht das dann so aus: deutsche Frage, neun Treffer, auf Platz eins das englische Handbuch. Die lexikalische Gegenprobe findet null Treffer, denn kein einziges der deutschen Suchwörter steht in diesem Text.
Warum dann überhaupt noch übersetzen?
An einer Stelle tun wir es doch, und der Unterschied lohnt die Erklärung.
Wer einen englischen Beleg vor sich hat, kann ihn sich auf Knopfdruck ins Deutsche übersetzen lassen. Auf Anforderung, nicht automatisch. Und das Original bleibt stehen. Die Übersetzung erscheint darunter, gekennzeichnet als „Lesehilfe“, mit dem Hinweis, dass das Original maßgeblich bleibt.
Diese Kennzeichnung ist keine Höflichkeit.
Hier ist, was passiert, wenn ein Sprachmodell auf einen Fachbegriff trifft. Derselbe englische Satz, zweimal übersetzt:
- Erster Versuch: „Der Welleventilator muss alle 500 Betriebsstunden inspiziert werden.“
- Zweiter Versuch: „Der Verdichter muss alle 500 Betriebsstunden inspiziert werden.“
Gemeint war das Laufrad, englisch impeller. Das Sprachmodell rät, und es rät jedes Mal anders. Bemerkenswert ist, was dabei stimmte: Zahlen, Einheiten und Teilenummern waren in beiden Fällen korrekt. Das war die harte Anforderung, denn ein Monteur handelt danach.
Inzwischen bindet das Glossar in NXTGN AI CORE die Übersetzung. Kommt ein gepflegter Fachbegriff im Text vor, bekommt das Sprachmodell die freigegebene Benennung der Zielsprache als Vorgabe mit. Dann steht dort, was dort stehen soll: „Das Laufrad muss alle 500 Betriebsstunden überprüft werden.“ Benennungen, die in der Terminologie als verboten markiert sind, schlägt NXTGN AI CORE nie vor.
Die Kennzeichnung als Lesehilfe bleibt trotzdem. Ein Glossar deckt die gepflegten Begriffe ab, nicht jeden Begriff.
Bestand und Anzeige
Dahinter steht eine Unterscheidung, die uns durch das ganze Vorhaben getragen hat: Bestand und Anzeige sind zweierlei.
Der Bestand ist das, was das System als wahr behandelt und woraus es zitiert. Dort gehört nichts hinein, was jemand nachträglich erzeugt hat. Die Anzeige ist das, was ein Mensch gerade vor Augen hat. Dort darf eine Hilfe stehen, solange sie als Hilfe erkennbar ist und das Original danebensteht.
Diese Grenze zu verwischen ist bequem und fällt zunächst niemandem auf. Sie wieder herzustellen ist fast unmöglich, denn man müsste in einem gewachsenen Bestand nachträglich unterscheiden, was Quelle war und was Erzeugnis.
Mein Resümee
Vieles am naheliegenden Weg war richtig gedacht. Übersetzen gilt als „gelöstes Problem“, die Werkzeuge liegen bereit, der Aufwand ist überschaubar. Nichts, wofür jemand ein Projekt aufsetzen würde.
Aber jede dieser Übersetzungen wäre in den Bestand gewandert, und ein Bestand ist zäh. Er wird gefunden, zitiert und weitergereicht, lange nachdem alle vergessen haben, dass da einmal übersetzt wurde. Ein Fehler darin altert nicht, er vermehrt sich.
Deshalb übersetzt NXTGN AI CORE nur dort, wo jemand hinsieht und das Original danebensteht. Klingt nach einer Kleinigkeit, ist aber der ganze Unterschied.
Dass etwas im Bestand falsch war, merkt man meistens erst, wenn niemand mehr da ist, der es besser wusste.